在端侧 AI 视觉开发的赛道上,流程繁琐、部署门槛高、设备算力不足,一直是开发者与项目落地的三大核心痛点。想快速搭起一套完整的 AI 视觉应用,往往要先啃解码、推理、前后处理的底层代码,再调试 NPU 加速、编解码适配,最后还要解决部署兼容问题,一套流程下来少则几周,多则数月。
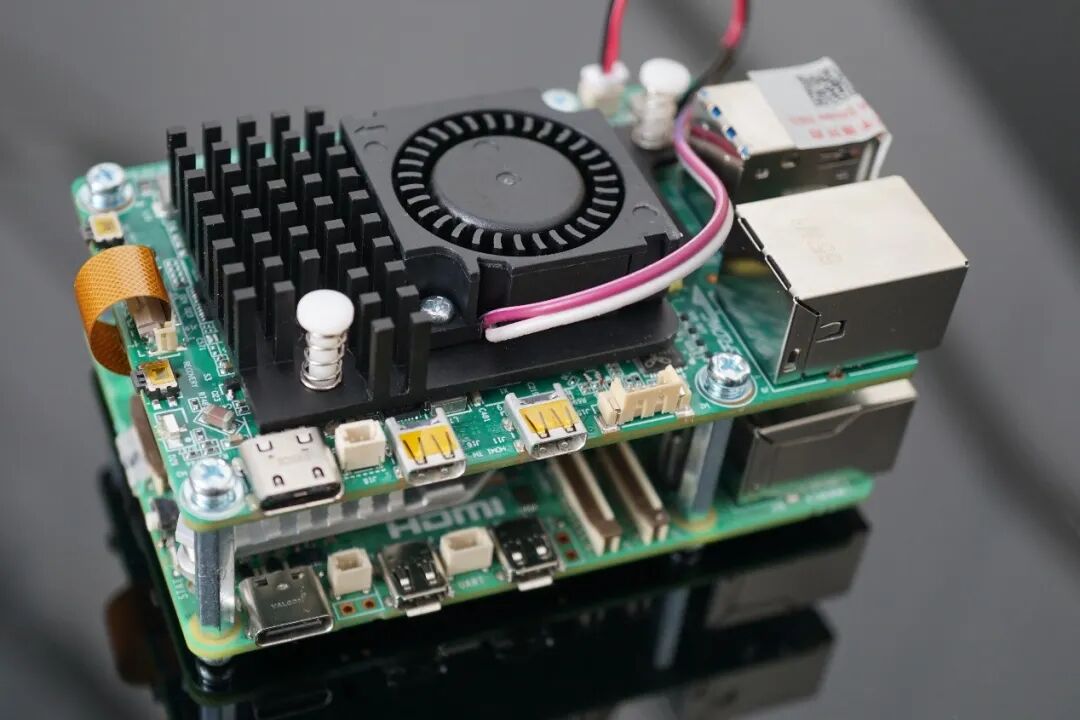
今天带来一套超高性价比、全流程开源的端侧 AI 解决方案:树莓派5 + AX8850 智能硬件组合,搭配专属 UNIStream 开源项目,从硬解码、前处理、NPU 推理、后处理、目标跟踪、OSD 叠加到硬编码,一站式打通完整视觉处理链路。零基础也能 3 步跑通项目,YOLOv8n 端到端帧率可达 250 FPS,性能直接拉满。
Github 地址:
https://github.com/UNIStream-Server/UNIStream
硬核硬件组合:小体积释放超强端侧算力
这套方案主打轻量化 + 高性能,适配端侧小型化、低功耗的部署需求,是创客开发、工业原型、IPC终端的理想选择。
核心硬件:树莓派5 + AX8850强强联合
AX8850 AI加速模块:
八核 Cortex-A55 @ 1.7 GHz 处理器
NPU 算力 24 TOPS @ INT8
64-bit LPDDR4x 内存接口
支持 H.264 / H.265 硬编解码
M.2 标准接口
国产自研 NPU,端侧算力拉满,多路视频并行处理无压力,长期满载稳定不降频。
树莓派5:
成熟生态 + GPIO 丰富;
兼容 USB / 摄像头 / 网络接口;
即插即用,上手零门槛。
补齐硬件交互与外设能力,让 AX8850 从“纯算力卡”变身完整端侧 AI 终端。
组合优势:解决端侧 AI 核心痛点
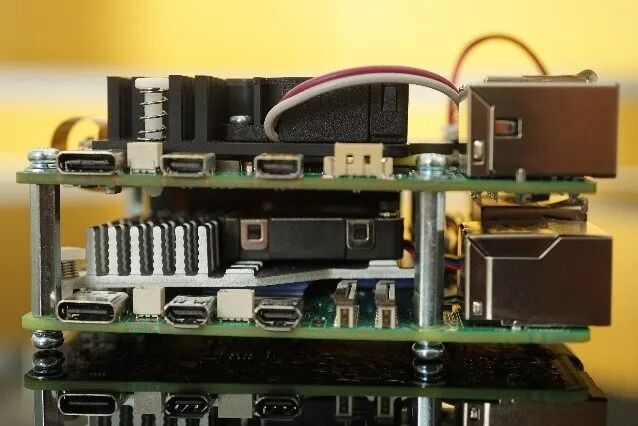
体积小:M.2 直插树莓派5,整机尺寸仅卡片级,适配嵌入式 / 便携场景;
成本低:相比其他高端开发板,性价比提升 50% 以上,无需额外采购算力模块;
生态稳:树莓派5生态 + 国产 AX 芯片技术支持,供货与售后无后顾之忧;
算力强:AX8850 的 NPU 算力彻底释放端侧设备潜力,告别“算力瓶颈拖慢帧率”。
UNIStream 开源框架:
全流程自动化,零代码改参
UNIStream 是本次方案的主角——一套完全开源的一站式端侧 AI 视觉框架,代码托管在 GitHub(https://github.com/UNIStream-Server/UNIStream),持续维护更新,欢迎开发者 Star、Issue 交流与二次开发贡献。它专为树莓派5 + AX8850 这类端侧硬件量身打造,核心价值是“打通全链路、配置化部署、开箱即用”:把过去需要自己拼接、反复调试的解码、推理、前后处理、跟踪、编码等零散组件,收敛成一条标准化流水线,彻底告别“调代码、改依赖、拼组件”的繁琐。

端到端 Pipeline:一站式跑通全流程
UNIStream 内置完整的视觉处理流水线,无需手动拼接第三方库,一次配置即可完成全流程运行:视频源(摄像头 / RTSP / 本地视频)→ 硬解码(VPU 加速,CPU 零占用)→ 智能前后处理(Letterbox / 归一化 / 色域转换,零拷贝优化)→ NPU 推理(YOLO / SSD / ResNet 等模型加速)→ 多目标跟踪(ByteTrack / SORT,防闪烁 / 跟丢)→ OSD 叠加(框 / 标签 / 置信度 / 计数 / 自定义文字)→ 硬编码(H.264 / H.265,输出 RTSP / MP4)。
主流模型快速起手:不用从零训练
框架深度适配工业级检测 / 分类网络,支持 YOLO、SSD、ResNet 等主流网络快速接入:
支持 YOLOv8 / YOLO11 全系列模型,从 nano 到 large 按需选择;
内置检测专属模型,适配门禁、客流、抓拍等场景。
JSON 极简配置:零代码改参,小白也能上手
所有参数配置均通过启动脚本和 JSON 配置文件完成,无需修改一行源码。只需修改 source 切换视频源、模型路径切换模型、osd / tracker / encoder 开关功能,重启即可生效,彻底降低部署门槛。
实测性能拉满:YOLOv8n 端到端 250 FPS
在树莓派5 + AX8850 硬件平台上,针对 UNIStream 框架进行了多轮实测。最亮眼的数据是:YOLOv8n 端到端帧率可达 250 FPS——这是从视频解码、前处理、NPU 推理、后处理、目标跟踪到 OSD 叠加、硬编码的全流程帧率,而非单点推理耗时,效率提升非常明显。
端到端 250 FPS:全流程不掉链子
YOLOv8n(640×640):端到端 250 FPS,CPU 占用率低于 8%,满足实时性要求极高的场景;
检测模型(320×320):400+ FPS,抓拍 / 客流统计无压力。
对比纯 CPU:效率提升明显
同样是 YOLOv8n,树莓派5 纯 CPU 推理只有 7~15 FPS、CPU 占用率超过 95%;接上 AX8850 后,帧率提升 15 倍以上,CPU 占用率下降 90% 以上。NPU 加速带来的效率跃升一目了然。
多路并行能力强
单张 AX8850 可同时处理 4 路 1080P 视频流,单路推理不影响其他通道性能。
3 步快速上手:5 分钟跑通第一个 AI 应用
UNIStream 提供一键部署脚本,全程无需手动编译依赖,小白也能快速上手。
步骤 1:硬件安装
断电树莓派5,将 AX8850 模块插入 M.2 E-Key 接口,拧紧固定螺丝;连接 RTSP 流或本地视频文件;接入 5V/3A 以上稳定电源,开机启动。
步骤 2:一键部署框架
bash
gitclonehttps://github.com/UNIStream-Server/UNIStream.git
cdUNIStream-main/tools
sudoapt install ./axcl_host_aarch64_*.deb
sudo./pre_required_helper.sh
mkdirbuild &&cdbuild
cmake ../ && make
cd../samples/test_run_pipeline && ./run.sh
步骤 3:运行与验证
启动后,终端会输出 FPS、推理耗时;在 RTSP 客户端(如 VLC)打开 rtsp://0.0.0.0:554/live,即可看到带 OSD 标注的 AI 处理结果。
典型应用场景:覆盖端侧 AI 全领域
智能IPC:人形 / 车辆检测、抓拍与识别、跌倒 / 徘徊等异常行为检测;
商业客流分析:客流统计、停留热力分析、客群粗分类,辅助门店运营与陈列优化;
工业质检:产线缺陷检测、目标计数、机械臂姿态校验,保障生产安全;
创客教育与科研:零基础 AI 视觉项目、算法快速验证、智能终端开发。
方案核心亮点总结
全流程闭环:硬解码 → 推理 → 跟踪 → OSD → 编码一站式打通,无需拼接第三方组件;
性能强悍:YOLOv8n 端到端 250 FPS,端侧设备也能实现高帧率实时推理;
国产硬件可靠:AX8850 国产自研,供货稳定、技术支持完善,适配端侧国产化部署需求;
配置化零门槛:JSON 改参即可切换模型、调整流程,无需精通底层开发;
开源可扩展:UNIStream 框架开源,支持 C++ / Python 二次开发,可自定义插件与场景;
开箱即用:预置检测模型、YOLOv8 / YOLO11 模型,无需额外训练,直接落地项目。
写在最后
端侧 AI 视觉开发,从来不用再走“调代码、改依赖、拼组件”的弯路。树莓派5 + AX8850 + UNIStream,用最小的部署成本、最强的端侧算力、最完整的流程闭环,帮开发者和项目方快速完成从 0 到 1 的 AI 视觉应用落地。