容量扩展,性能兼顾
解码三星 CXL 内存池化的 AI 推理能力
以 CXL 内存池化应对 KV Cache 扩展挑战
随着生成式 AI 加速普及,AI 基础设施关注重点正逐步从单纯训练性能拓展至更广泛的系统能力。对于在生产环境中部署大语言模型(LLM)的企业而言,推理效率与可扩展性已成为实现高响应、具成本效益 AI 服务的关键因素。
其中,一个日益突出的挑战是 KV Cache(Key-Value Cache,键值缓存)需求的快速增长。随着上下文长度不断增加、并发用户数量持续上升,KV Cache 所需的内存容量可能很快超过可用的 GPU 显存及系统 DRAM 资源,由此形成 AI 推理基础设施中的新瓶颈。
为应对这一挑战,三星评估了基于 CXL 的内存池化方案用于 KV Cache 卸载,重点探索其能否在维持接近传统 DRAM 性能的同时,实现可扩展的内存容量扩展。
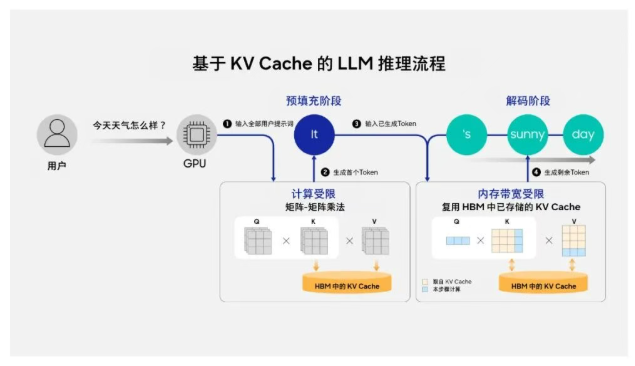
图1. 基于 KV Cache 的 LLM 推理流程
为什么 KV Cache 至关重要
在推理过程中,LLM 会利用 KV Cache 存储此前已计算得到的键向量(Key)和值向量(Value)。通过复用这些数据,而无需在生成每一个新 Token 时重复计算,可显著降低推理时延和计算开销。
然而,随着模型规模、上下文长度和用户并发量持续增长,KV Cache 的容量需求很容易达到数百 GB。基于 SSD 或网络附加内存的传统卸载方式虽然可以缓解容量限制,但通常会引入额外的时延与带宽开销。
CXL 内存池化带来的新机遇
Compute Express Link(CXL)正在成为下一代数据中心架构中的关键技术之一。通过具备内存一致性的高带宽互连实现内存扩展,CXL 可帮助系统突破传统 DRAM 配置的物理限制。
当 CXL 与 CXL 交换机结合使用时,可将多个内存设备聚合为共享内存池,从而实现灵活的内存资源分配,并显著提升可用内存容量。
三星 CMM-D(CXL Memory Module-DRAM)旨在支持此类内存扩展架构,为 AI 推理等内存密集型工作负载提供具有吸引力的解决方案。
评估 CXL 内存
在 AI 推理场景中的表现
本次评估环境由 NVIDIA RTX PRO 6000 Blackwell GPU、通过 CXL 交换机连接并配置为 1TB CXL 内存池的三星 CMM-D 模块、vLLM¹ 与 LMCache² 软件栈,以及基于三星相关技术方案的主机侧优化共同构成。
本次评估所要回答的核心问题十分明确:CXL 内存池能否在支持大规模 KV Cache 卸载的同时,维持与 DRAM 相当的性能?
图2. 环境评估系统框图
在更大规模下实现接近 DRAM 的性能
评估结果表明,在 AI 推理工作负载中,CXL 内存池化能够同时提供接近 DRAM 的性能与显著的内存扩展能力。
在单 GPU 配置下,当优化后的 CXL 内存池作为 LMCach 后端使用时,其性能可与 DRAM 相当。在采用 8 张 GPU 的多 GPU 环境中,CXL 内存池在提供显著更大内存容量的同时,仍可维持约 92% 的 DRAM 性能。
研究还在 KV Cache 需求持续增长的情况下,对 512GB DRAM 配置与 1TB CXL 内存池进行了比较。当 KV Cache 需求超过可用 DRAM 容量后,由于产生 KV Cache 重新计算开销,系统性能开始下降。相比之下,CXL 内存池能够容纳显著更大的 KV Cache 内存占用规模,并保持稳定性能。
面向 AI 基础设施的内存池化未来
三星的评估结果显示,对于 KV Cache 卸载工作负载,基于 CXL 的内存池化可在实现大幅内存扩展的同时,提供接近 DRAM 的性能。
随着 CXL 生态系统不断成熟,内存池化架构预计将成为未来 AI 数据中心的重要基础构件,推动基础设施向更加灵活、可扩展且高效的方向演进。
[1] 白皮书:《Optimizing KV Cache Offloading to CMM-D in a CXL Switch-based Memory Pool》
https://download.semiconductor.samsung.com/resources/white-paper/Optimizing_KV_Cache_Offloading_to_CMM-D_in_a_CXL_Switch-based_Memory_Pool.pdf
¹ vLLM 是一款开源 LLM 推理引擎,可通过高效利用 GPU 显存提升推理吞吐量。
² LMCachе 是一个开源框架,可支持 KV Cache 在多个内存层级中进行存储与复用,包括 GPU 显存、CPU 内存、CXL 内存和 SSD。